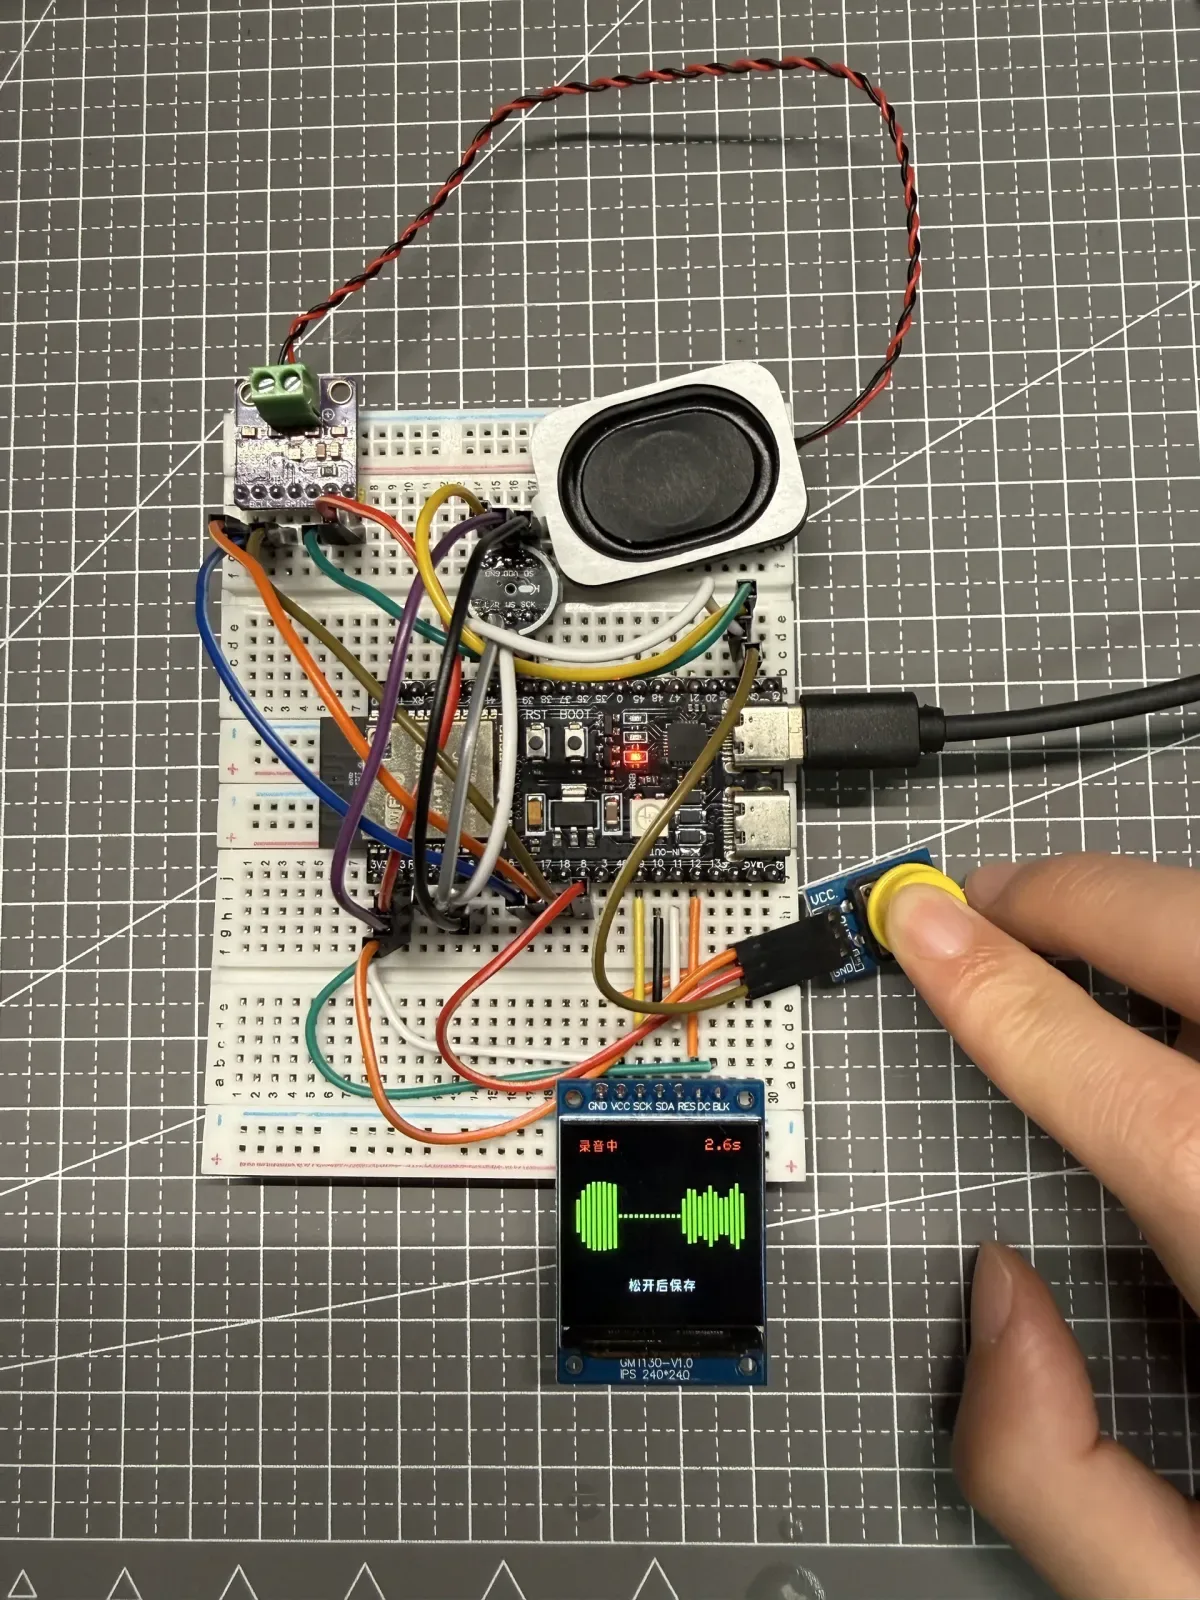
第一次完整走通按钮录音时,松开按钮,屏幕直接显示了 ERROR。
修复一个 Base64 缓冲区问题后,ERROR 消失了,但录音仍然短得不正常:按住几秒,只得到几百毫秒对应的采样量。真正的问题并不在麦克风,而在同一个 Arduino 主循环里,低速 SPI 屏幕重绘不断阻塞 I²S 读取。
先定义问题:ERROR 修好,不代表录音已经正确
当前环境是 ESP32-S3、INMP441、240 × 240 ST7789 屏幕。麦克风以 16 kHz、单声道、I²S 32-bit 容器采样;屏幕使用 SPI Mode 3、1 MHz。按钮按住期间录音,松开后导出。
最早的两次录音持续约 5.4 秒,却只有 1280 个采样点。按 16 kHz 计算:
1280 / 16000 = 0.08 秒也就是说,录音操作持续了 5 秒多,缓冲区中真正留下的音频却只有约 80 ms。屏幕上的 ERROR 只是显性症状,严重欠采样才是更关键的问题。
第一层故障:Base64 输出缓冲区少了终止符空间
诊断固件最初通过串口导出原始音频。每次读取 384 字节输入,再调用 Mbed TLS 生成 Base64。384 字节恰好编码为 512 个 Base64 字符,但代码还会在末尾写入一个 \0。旧缓冲区只分配了 512 字节,没有为终止符留位置,因此返回 -42,也就是输出缓冲区过小。
Mbed TLS 的 Base64 API 文档明确说明:目标缓冲区不足时会返回 buffer too small,并可先获取所需长度。固件后来把大小计算集中到 encodedBufferSize(),避免再次手写边界。
uint8_t encoded[
    serial_audio_protocol::encodedBufferSize(kExportChunkBytes)];

const int error = mbedtls_base64_encode(
    encoded,
    sizeof(encoded),
    &encoded_length,
    raw + offset,
    chunk);

encoded[encoded_length] = '\0';
这一修复让松开按钮后的 ERROR 消失了,但不能解释为什么录音采样点仍然少得离谱。
第二层故障:错误消失后,采样仍然不完整
修复 Base64 后继续看数据,而不是只看屏幕状态,问题仍然存在:
| 测试 | 按键时长 | 实际采样点 | 折算音频长度 |
|---|---|---|---|
| 早期错误阶段 | 约 5.4 秒 | 1280 | 约 0.08 秒 |
| Base64 修复后 | 3304 ms | 5120 | 约 0.32 秒 |
| 继续测试 | 约 5 秒 | 9216 | 约 0.576 秒 |
这组数据很关键:编码错误已经修复,但采集吞吐仍然不够。若只把“屏幕不再显示 ERROR”当作验收标准,问题会被过早宣布解决。
真正的根因在同一个主循环里
当时的程序结构把三类工作放在同一个循环中:
-
读取 INMP441 的 I²S 数据。
-
检测按钮按下和松开。
-
向 ST7789 绘制计时、文字和声量波形。
I²S 采集需要持续取走接收缓冲区里的数据。屏幕却使用 1 MHz SPI,大面积 fillScreen()、清区域和重绘文字都可能占用相当长的主循环时间。主循环忙着画屏幕时,没有及时调用 readBytes();结果就是“界面一直刷新,录音却只留下零散数据”。
这里需要谨慎限定:结论来自本项目的 ST7789 Mode 3、1 MHz 配置,并不意味着所有 ST7789 或所有 SPI 速度都会拖垮录音。真正可以迁移的判断方法是:用理论采样点与实际采样点比较,确认采集是否被其他同步任务饿死。
ESP32-S3 的 I²S 标准模式和读数据方式可参考 Espressif ESP32-S3 I²S 文档。
为什么只减少一次屏幕刷新还不够
第一轮界面优化减少了大面积清屏,把波形改成较小区域更新。录音数量有所增加,却仍远低于目标。这说明“优化屏幕”方向是对的,但只要 I²S 读取仍依赖主循环及时返回,它就仍会受到任何慢操作影响。
最终没有继续在同一个循环里压榨刷新时间,而是改变任务边界:
-
采样任务:持续阻塞式读取 I²S,把数据写入 PSRAM,并计算供界面使用的最新 RMS 包络。
-
主循环:检测按钮、处理最长录音时间、发送心跳,以及按计划刷新屏幕。
-
共享状态:主循环只读取最新声量值、采样计数、结束请求和错误码,不参与每批音频数据搬运。
核心修复:独立 FreeRTOS 采集任务
ESP-IDF 的 FreeRTOS SMP 提供 xTaskCreatePinnedToCore(),可以为任务指定核心亲和性。固件把采集任务固定到 core 0,栈大小 4096,优先级 2。相关行为可在 ESP-IDF FreeRTOS SMP 文档 中核对。
xTaskCreatePinnedToCore(
    [](void *) {
      while (!capture_stop_requested) {
        const size_t bytes_read = microphone.readBytes(
            reinterpret_cast<char *>(read_buffer),
            sizeof(read_buffer));

        // 写入 PSRAM,并更新最新 RMS 包络
      }
      capture_task_running = false;
      vTaskDelete(nullptr);
    },
    "voice_input_capture",
    4096,
    nullptr,
    2,
    nullptr,
    0);
改造后,5 秒录音得到完整的 80,000 个采样点。随后又验证了松开按钮的结束路径:4109 ms 得到 65,536 个采样点,理论值约 65,744,差异约 0.32%。这说明按键结束、任务停止和缓冲区计数能够协同工作。
让屏幕更流畅,但不再干扰采样
采样完整后,波形仍有明显“一帧一帧刷新”的感觉。第二轮优化没有提高全屏刷新频率,而是把不同内容拆成不同节奏:
| 界面元素 | 刷新策略 | 原因 |
|---|---|---|
| 声量波形 | 每 40 ms,约 25 FPS | 人眼能看到更连续的起伏 |
| 录音计时 | 每 200 ms | 文字无需跟波形同频刷新 |
| 波形绘制 | 32 根柱,每次更新一根 4 px 窄柱 | 只擦除局部,不清整片区域 |
| 声量输入 | RMS + attack/release 平滑 | 减少跳变,同时保留说话响应 |
tft.fillRect(
    x,
    center_y - maximum_height,
    bar_width,
    maximum_height * 2,
    ST77XX_BLACK);

tft.fillRect(
    x,
    center_y - new_height,
    bar_width,
    new_height * 2,
    ST77XX_GREEN);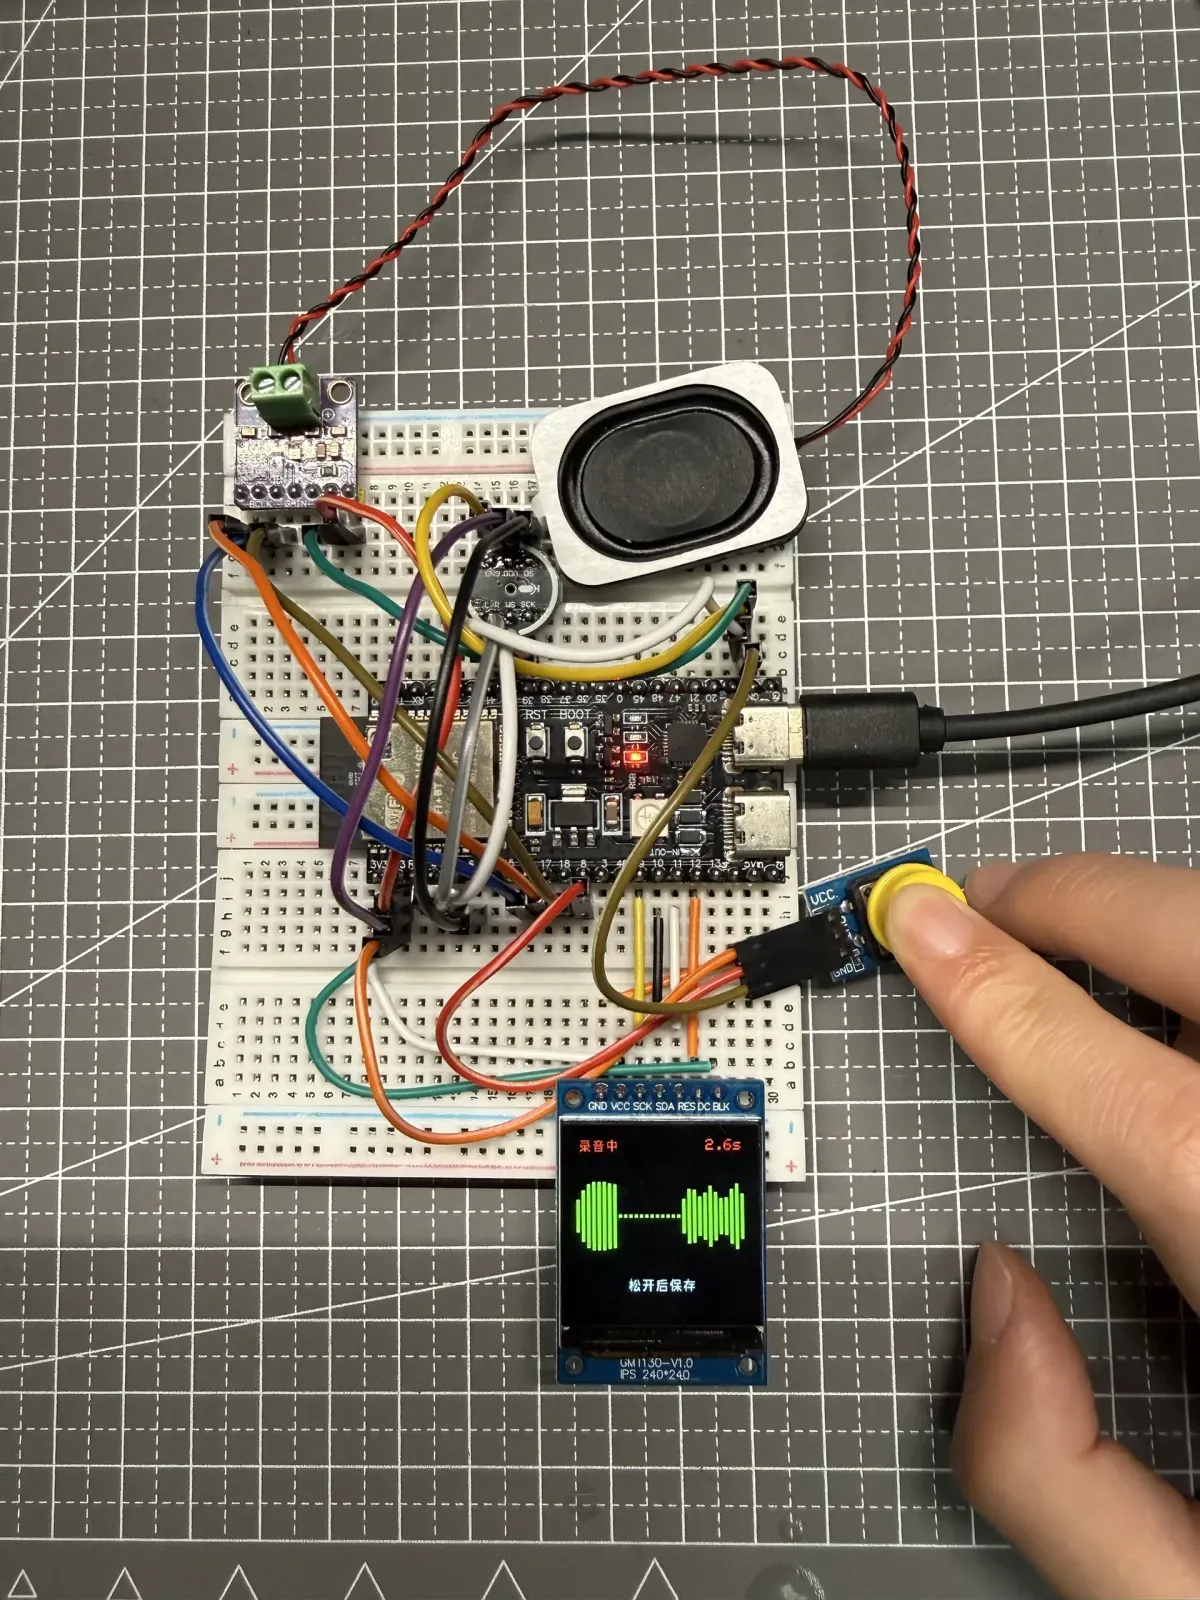
面包板上的 ESP32-S3、INMP441、屏幕和按钮正在进行录音测试;屏幕显示录音状态、计时和绿色相对声量波形。
最后一次联合验证
界面优化之后,不能只看动画变顺,还要重新检查采样是否退化。最终一次联合验证结果如下:
| 指标 | 结果 |
|---|---|
| 按键录音时长 | 3827 ms |
| 实际采样点 | 61,184 |
| 16 kHz 理论采样点 | 约 61,232 |
| 差异 | 约 0.08% |
| 主观界面观察 | 说话时声量柱明显起伏,刷新更加流畅 |
| 结束状态 | SHA 与采样数量一致,设备返回空闲状态 |
这次验收同时覆盖“音频完整”和“交互流畅”。任何一项单独通过,都不能代表录音功能完成。
这次排查可以复用的顺序
-
先把现象量化。记录按键时长、采样率和实际采样点,不用“听起来有点短”代替数据。
-
分别处理显性错误和深层错误。Base64 的
-42是真实故障,但不是唯一故障。 -
验证每次修复是否改变核心指标。屏幕不再报错后,仍要复算音频长度。
-
找到共享执行路径上的慢操作。屏幕、网络、日志和文件操作都可能阻塞实时采样。
-
必要时改变任务边界。当连续采样与界面绘制的实时要求不同,仅做局部微调可能不够。
-
优化界面后重新测采样。性能优化不能靠观感验收,要防止一边变流畅、另一边再次丢数据。
公开代码
与当前设备版本一致的固件位于 qh-video-voicebot / 008-voice-input / esp32。其中可以看到独立采集任务、显示调度器、声量包络、WAV 构建和上传策略的完整实现。
公开代码不包含真实 Wi-Fi 密码、设备令牌、服务端数据或模型文件。示例配置只用于说明必须提供哪些变量。