语音录入功能,终于搞定了。
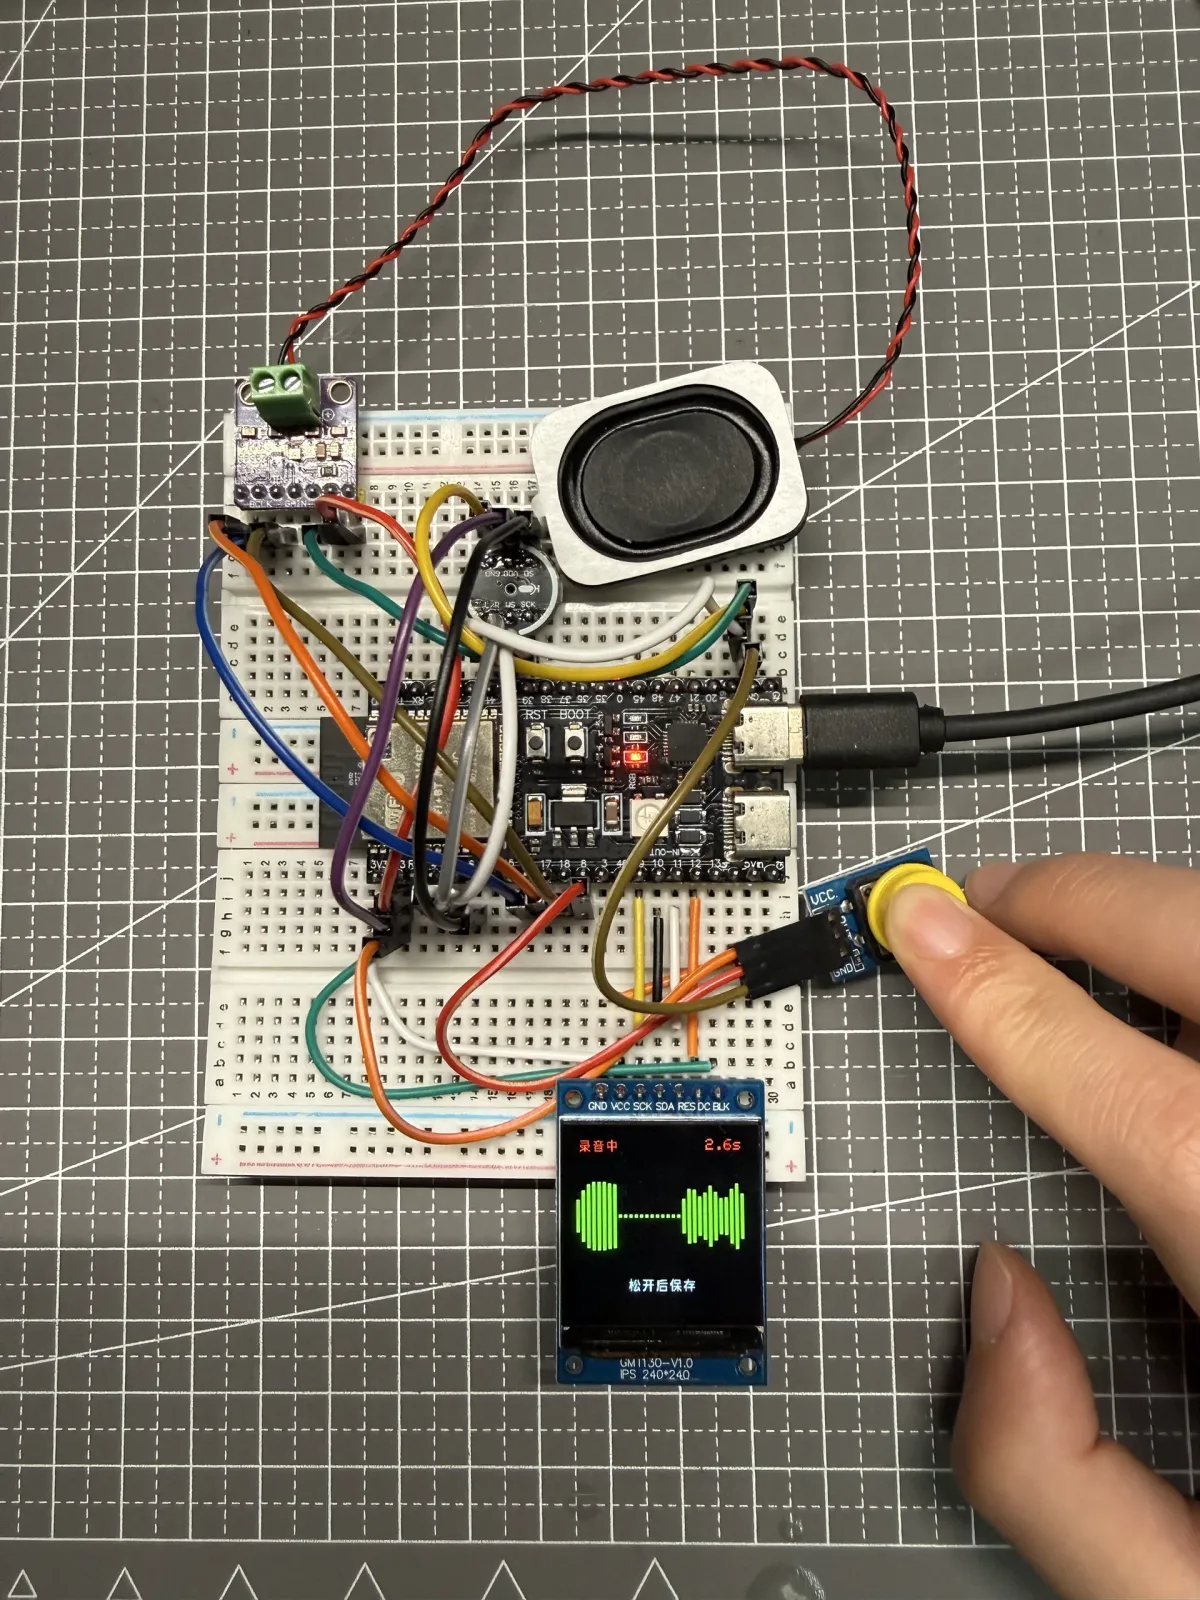
现在按住按钮说一句话,松开后,ESP32-S3 会把录音封装成 WAV 并自动上传;服务端保留原始录音,生成清晰处理版,再交给 whisper.cpp 转成文字。打开网页,就能看到设备状态、上传结果和识别文本。
先看结果和适用范围
| 项目 | 本次实测状态 |
|---|---|
| 输入硬件 | ESP32-S3 + INMP441 数字麦克风 + 独立按钮 |
| 采集格式 | 16 kHz、单声道、I²S 32-bit 容器;导出为 PCM16 WAV |
| 最长录音 | 5 秒,对应 80,000 个采样点 |
| 设备反馈 | 中文状态、录音计时、32 根绿色相对声量柱 |
| 服务端结果 | 校验并保存原始版与清晰处理版,后台启动语音转文字 |
| 当前边界 | 尚未把转写文字交给 LLM,也未形成自动回答闭环 |
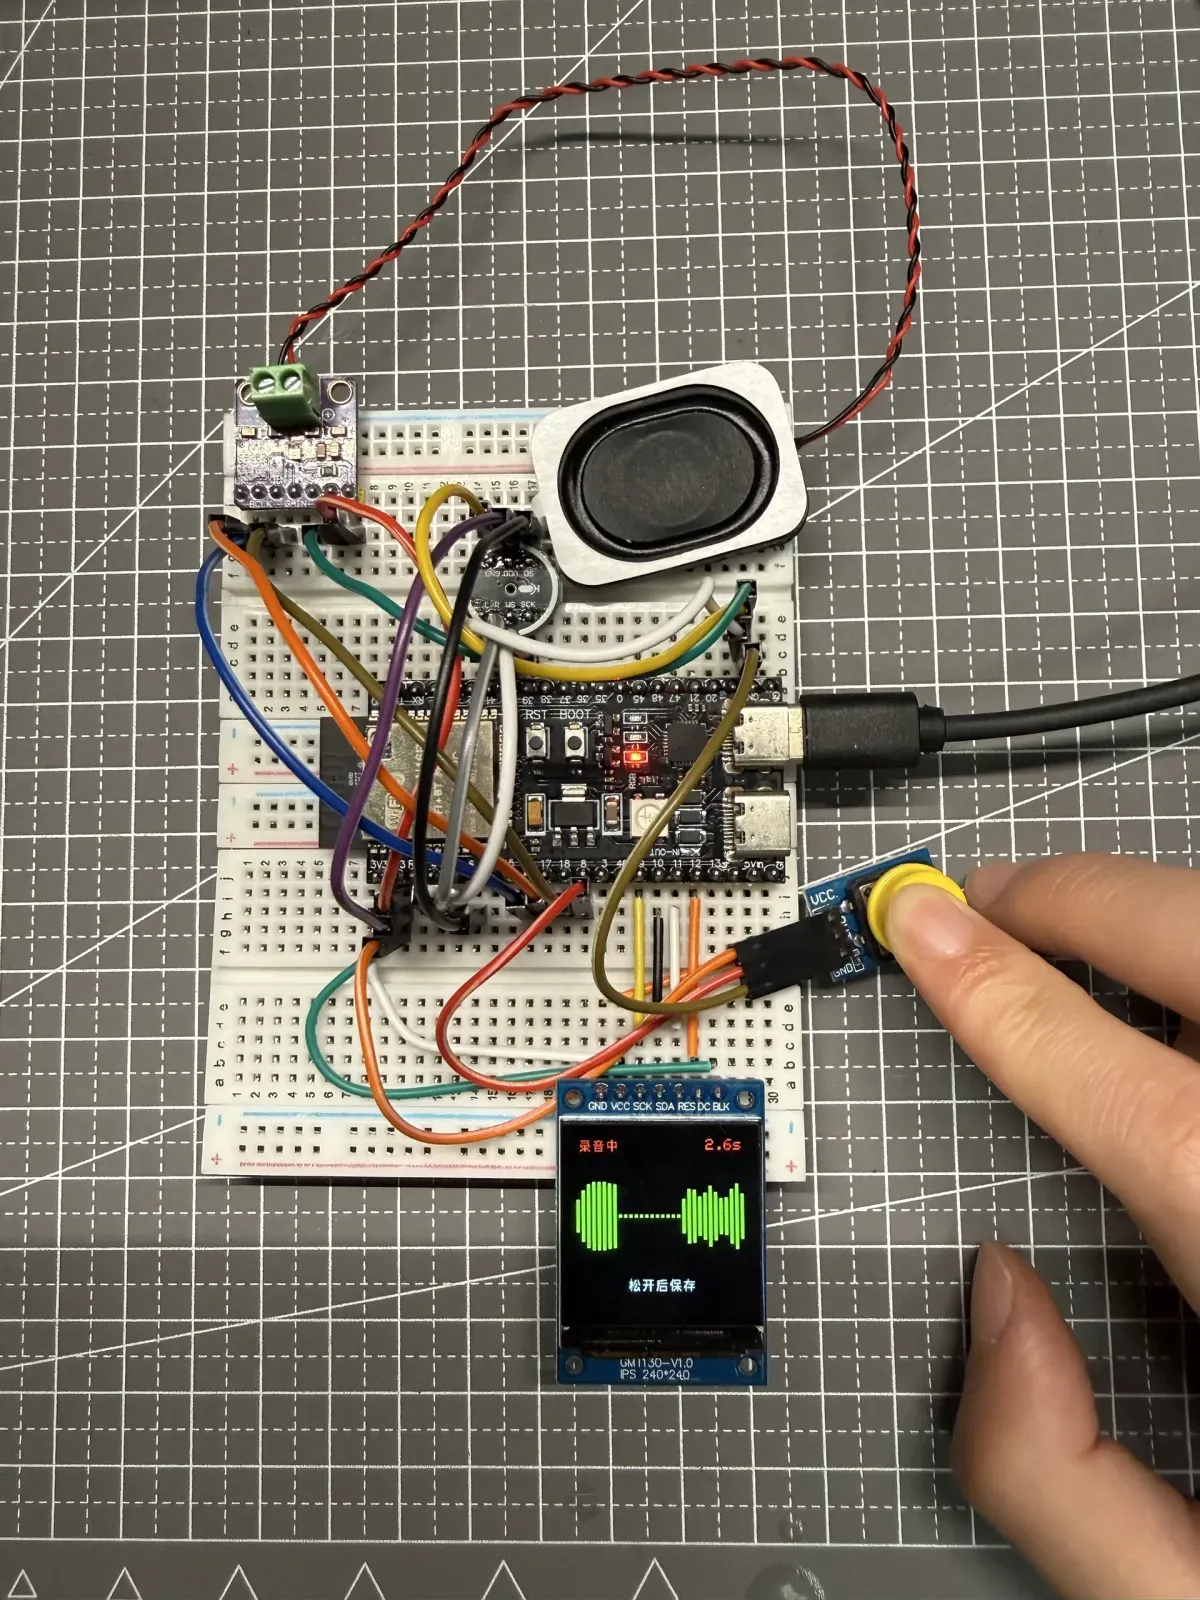
按住黄色按钮录音时,屏幕显示“录音中”、计时和绿色相对声量波形。
整条语音输入链路是怎样工作的
这不是“麦克风接上以后调用一个识别接口”这么简单。真正需要稳定工作的,是采样、交互、文件、网络、服务端处理和网页展示组成的一条连续数据链。
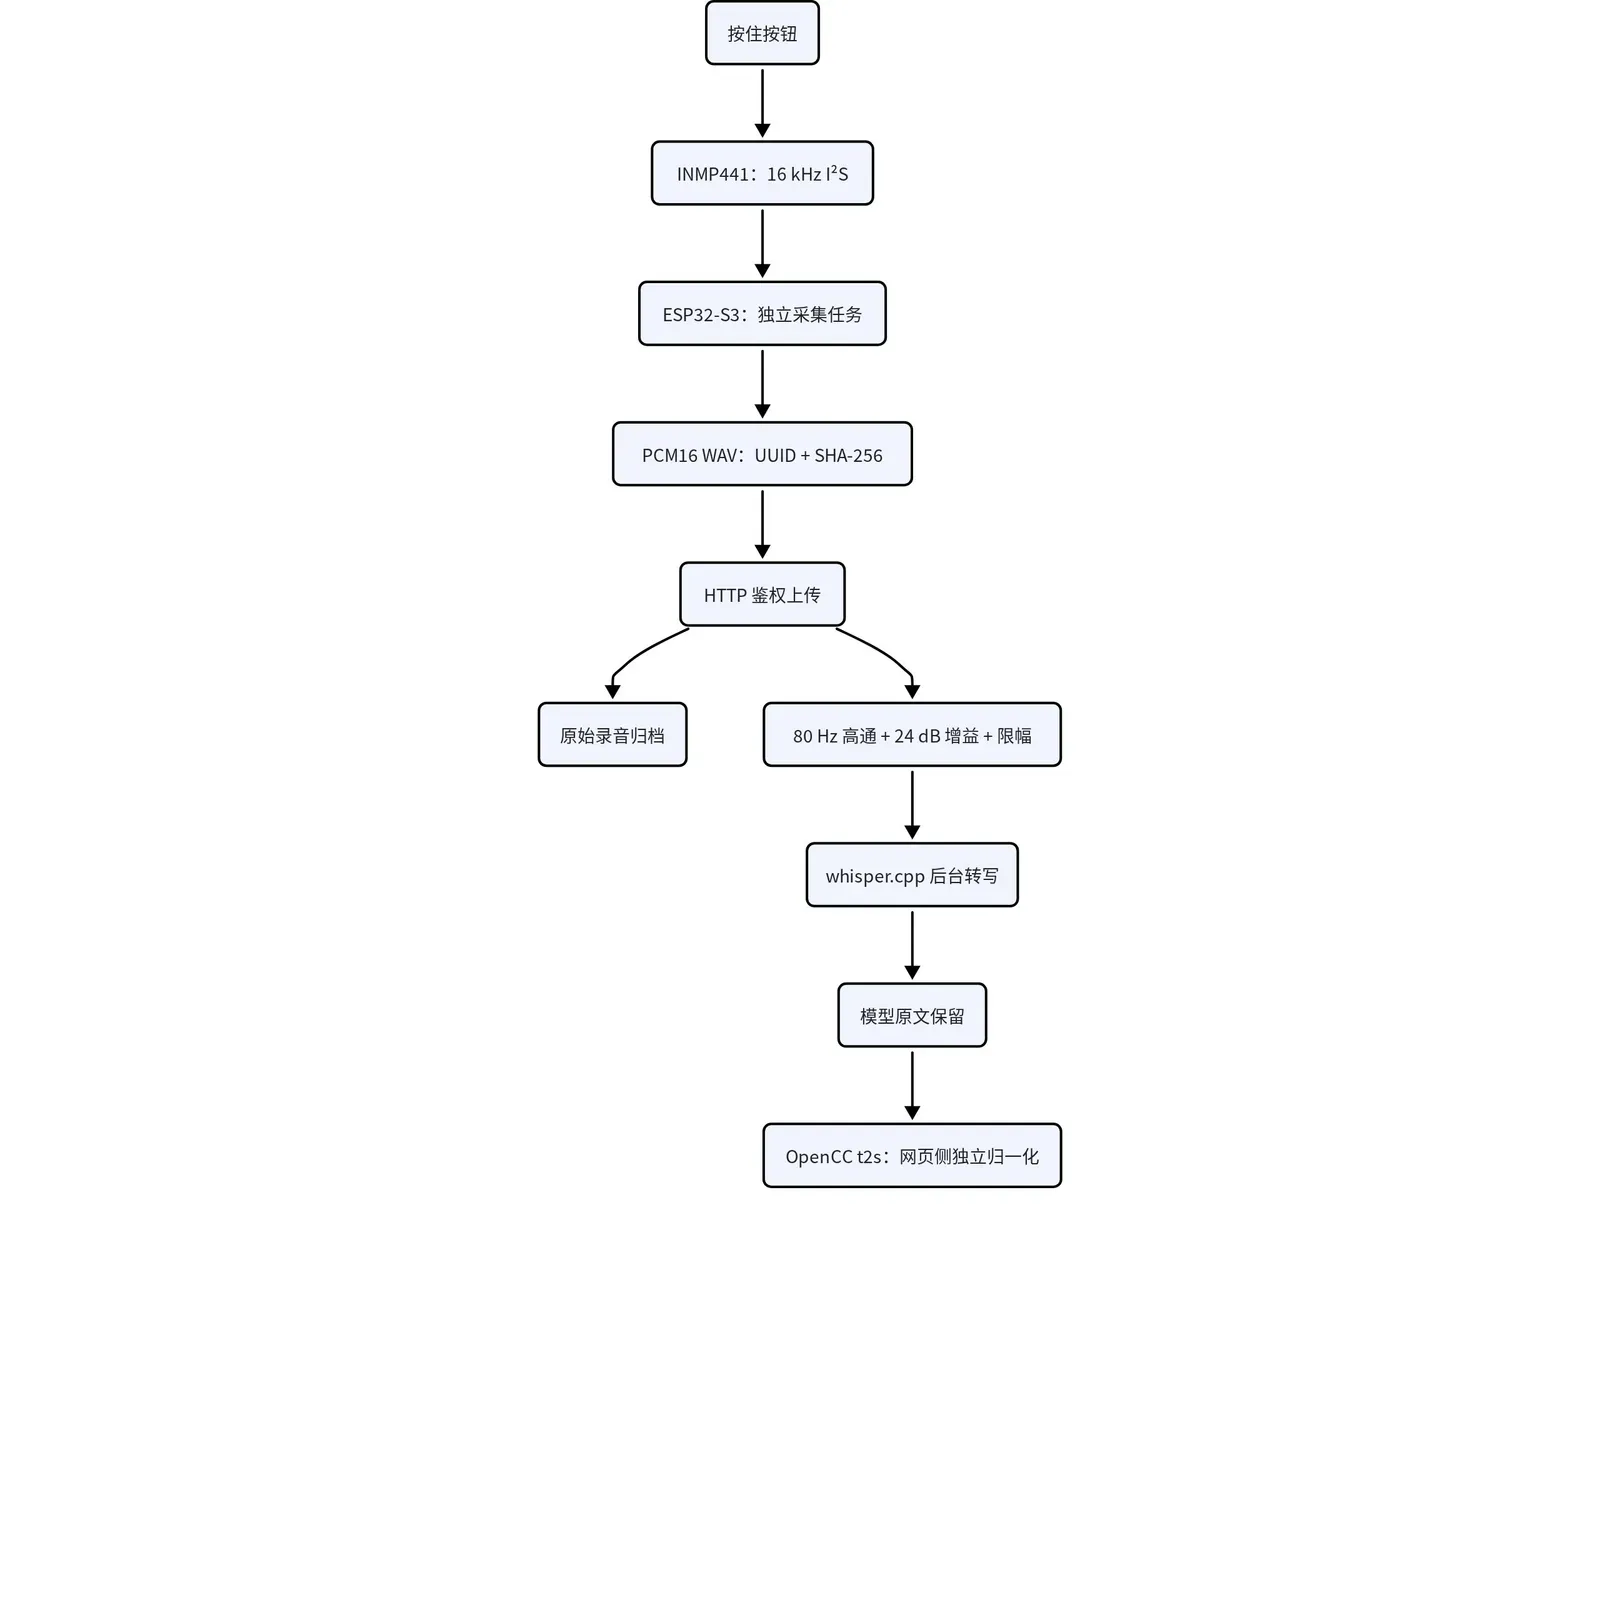
从按住按钮、I²S 采集和 WAV 上传,到原始录音归档、清晰版处理、whisper.cpp 转写与网页简体归一化的语音输入链路。
其中有两条重要边界:
-
原始数据不被覆盖。设备上传的 WAV 保留为低电平归档,清晰版是服务端生成的派生文件。
-
繁体转简体不进入未来对话关键路径。模型原文先保留;网页需要时再执行独立、可重试的 OpenCC t2s 归一化。这样不会为了显示文字而增加设备回答的等待时间。
硬件接线:为什么固定读取左声道
本次接线使用以下端点。按钮和屏幕沿用项目中已经验证的接线,表格只列出 INMP441。
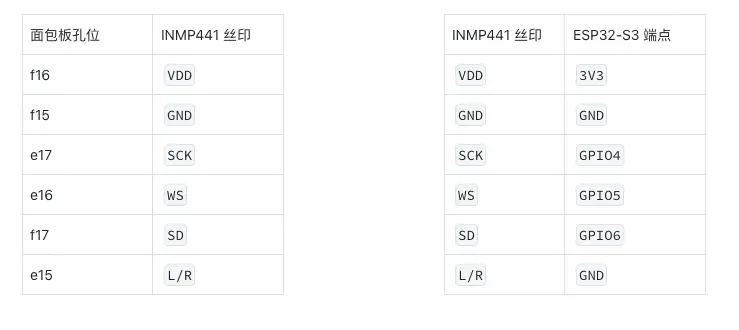
本次实测使用的 INMP441 面包板孔位和 ESP32-S3 端点映射。
| INMP441 | ESP32-S3 | 用途 |
|---|---|---|
| VDD | 3V3 | 供电 |
| GND | GND | 公共地 |
| SCK | GPIO4 | I²S 位时钟 BCLK |
| WS | GPIO5 | 左右声道字选择 |
| SD | GPIO6 | 麦克风数据输出 |
| L/R | GND | 选择左声道时隙 |
INMP441 虽然只有一个麦克风单元,仍按 I²S 的左右时隙发送数据。L/R 接低电平时,它在左声道时隙输出;接高电平时,则在右声道时隙输出。因此固件必须与接线一致,明确读取左时隙。右声道并没有“消失”,只是当前总线上没有把第二只麦克风配置到右时隙。这个行为可在 TDK INMP441 数据手册 和 Arduino-ESP32 I²S 文档 中核对。
microphone.setPins(4, 5, -1, 6);
microphone.begin(
    I2S_MODE_STD,
    16000,
    I2S_DATA_BIT_WIDTH_32BIT,
    I2S_SLOT_MODE_MONO,
    I2S_STD_SLOT_LEFT);
先让采样稳定,再做屏幕动画
最初把 I²S 读取、按钮检测和屏幕刷新全部放在 Arduino 主循环中。屏幕使用 ST7789,实测配置为 SPI Mode 3、1 MHz。录音过程中大面积清屏和重绘会长时间占住主循环,结果是界面看起来在工作,实际录到的采样点却远少于时间应该对应的数量。
最终方案是把 I²S 连续读取移动到固定于 core 0 的 FreeRTOS 任务。主循环只负责按钮状态、录音结束条件、心跳和屏幕调度。ESP-IDF 的 FreeRTOS SMP 文档说明了 xTaskCreatePinnedToCore 的核心亲和性;这里使用它的目的,是让采样不再等待屏幕绘制结束。
xTaskCreatePinnedToCore(
    captureTask,
    "voice_input_capture",
    4096,
    nullptr,
    2,
    nullptr,
    0);
波形也没有直接绘制原始振幅,而是计算一批采样的中心化 RMS,经过噪声底、上限和 attack/release 平滑后,映射为 32 根窄柱。波形每 40 ms 更新一次,约 25 FPS;计时文字每 200 ms 更新一次。每帧只擦除并重画一根 4 px 宽的柱,不再反复清整块区域。
| 项目 | 参数 | 目的 |
|---|---|---|
| 波形刷新 | 40 ms | 让声量变化连续可见 |
| 计时刷新 | 200 ms | 减少文字重绘 |
| 声量柱 | 32 根,宽 4 px | 局部更新,不做大面积清屏 |
| 包络参数 | attack 0.60 / release 0.15 | 说话时快速抬升,安静时平滑回落 |
最终一次联合验证记录为 3827 ms、61,184 个采样点;按 16 kHz 计算,理论值约为 61,232,差异约 0.08%。同时,实际观察确认波形已经明显更流畅。
从 32-bit I²S 样本生成标准 WAV
设备内存中保存的是 32-bit I²S 容器。导出时取高 16 位生成单声道 PCM16,并补上 44 字节 RIFF/WAVE 文件头。WAV 的 fmt 和 data 分块、采样率、通道数和位宽字段可参考 Microsoft 的 RIFF/WAVE 说明。
最长 5 秒录音需要 80,000 个 32-bit 采样点,采集缓冲区和 WAV 缓冲区都放在 PSRAM。按钮按下不足 300 ms 会取消,达到 5 秒则自动结束,避免无限占用内存。
第一次可完整导出的原始录音并不是“没有数据”:67,328 个采样点中,99.2499% 为非零值;问题是电平很低,RMS 为 -48.5137 dBFS,峰值为 -29.7213 dBFS,直接播放很难听清。
因此服务端保留两份文件:
-
原始采集:逐字节保存设备上传的 WAV,用于归档、复查和重新处理。
-
清晰处理版:80 Hz 高通、24 dB 增益,并把峰值限制在 PCM16 的安全范围内,用于试听和语音识别。
对应样本的清晰版 RMS 为 -31.0563 dBFS,比原始版提高约 17.46 dB。它不是替换原文件,而是可追溯的派生版本。
上传协议:先校验身份和数据,再启动识别
ESP32 通过 POST /api/v1/device/recordings 上传 audio/wav。请求包含 Bearer 设备令牌、标准 UUID、音频 SHA-256、16 kHz 采样率和单声道声明。固件最多尝试 3 次,单次超时 15 秒。
http.addHeader("Authorization", String("Bearer ") + VOICE_DEVICE_TOKEN);
http.addHeader("Content-Type", "audio/wav");
http.addHeader("X-Recording-Id", recording_id);
http.addHeader("X-Audio-Sha256", wav_sha256);
http.addHeader("X-Sample-Rate", "16000");
http.addHeader("X-Channels", "1");
服务端不会只相信请求头。它重新计算 SHA-256,检查 UUID、文件大小、WAV 是否为未压缩 PCM、采样率是否为 16 kHz、是否为单声道、位宽是否为 16 bit,并核对文件头与实际数据长度。全部通过后,才以原子写入方式保存文件、生成清晰版并登记数据库。
同一 recording ID 再次上传相同内容时可以安全返回已有记录;若 ID 相同但哈希不同,则拒绝请求。这让设备重试不会产生重复录音,也不会静默覆盖另一段数据。
转写和简体显示为什么要分成两层
上传成功后,FastAPI 使用后台任务把清晰处理版交给本地 whisper.cpp。调用时明确指定多语言模型、中文语言参数、不输出时间戳,并把模型返回内容作为“原始转写”保存。whisper.cpp 的语言与初始提示等参数可在其 公开头文件 中核对。
实际测试中,中文模型可能返回繁体字。单靠提示词可以改善某个样本,却不能保证严格转换,因此没有把提示词当成唯一方案。网页侧需要统一显示时,再调用 OpenCC 的 t2s.json 做繁体转简体;原文、归一化结果、版本、耗时和失败状态分别保存。OpenCC 官方说明列出了 Traditional Chinese to Simplified Chinese 的标准配置。
这层转换被设计成独立、可重试的网页能力。未来设备要回答问题时,原始转写可以直接进入对话流程,不必等待 OpenCC;网页则可以显示 loading,并在转换完成后展示简体文字。
网页上的真实结果
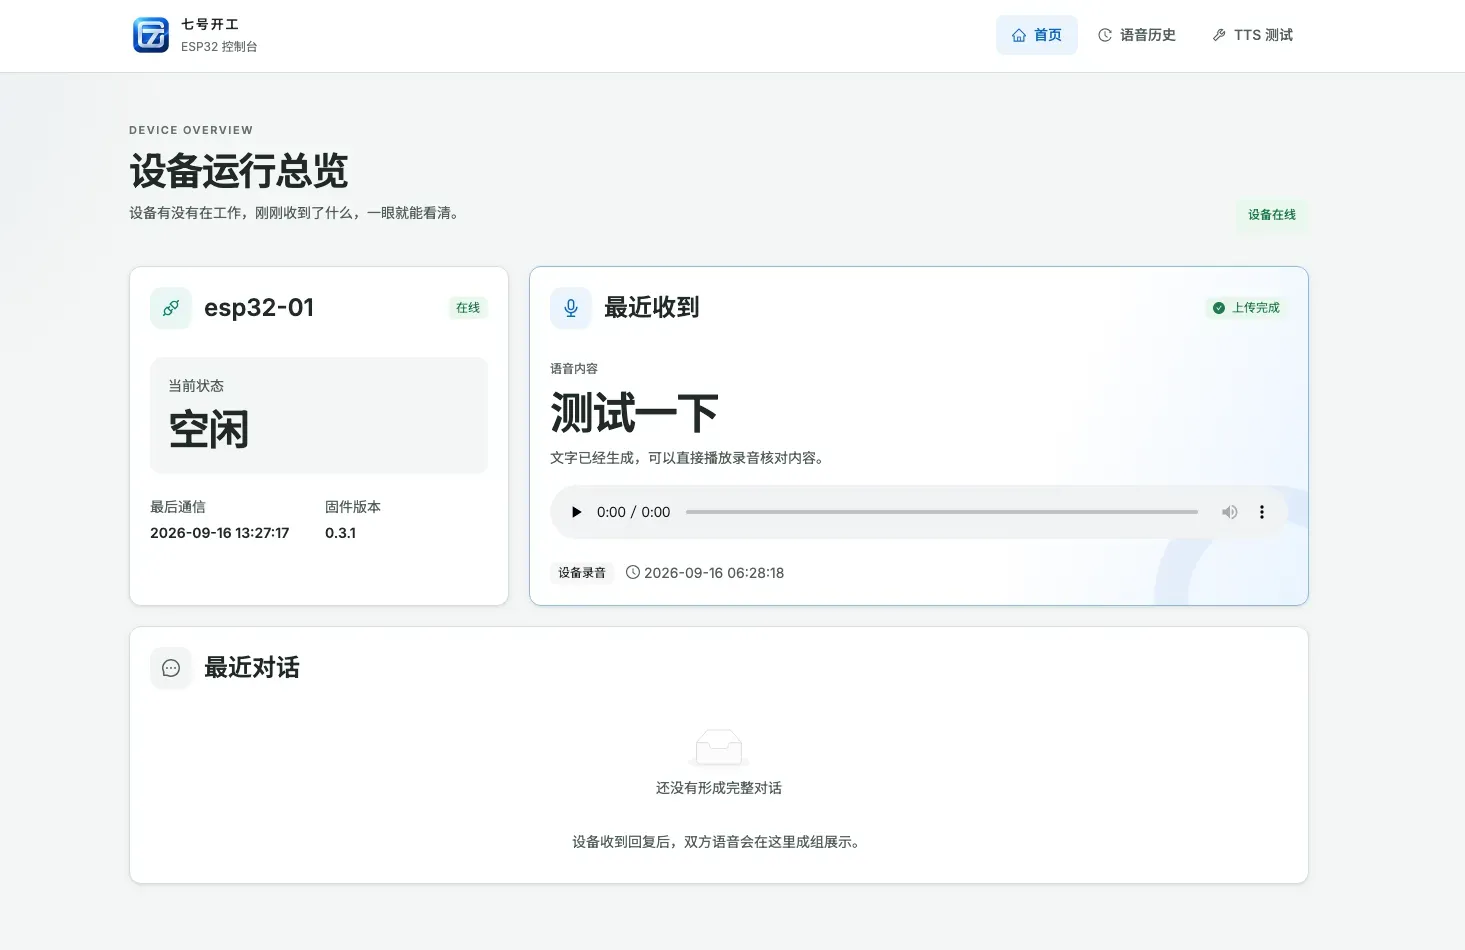
真实设备录音上传后,网页显示设备在线、上传完成和识别文字“测试一下”;完整对话仍未形成。
这张截图能够证明:设备心跳已经进入网页、最近录音已经上传、文字已经生成。播放器当时显示 0:00 / 0:00,因此本文不把截图作为音频时长或播放正确性的证据;音频可听性来自前面的独立播放测试。
下方“最近对话”仍显示空状态,这也准确反映当前边界:系统已经能听见,但还没有把识别内容交给 AI 并形成问答。
公开代码和复现入口
与当前 ESP32 中版本一致的公开固件位于 qh-video-voicebot / 008-voice-input / esp32。目录包含 Arduino 源码、辅助头文件、示例密钥配置和 README,但不包含真实密码、令牌、服务端数据库或本地模型。
做到这里,语音对话大约完成了50%
“50%”是我对当前项目进度的主观判断,不是按代码量计算的精确指标。输入侧已经贯通:设备可以采集、显示、封装、上传、处理并转写语音。
下一步,是把识别出来的文字交给 AI,让它根据我说的话生成回答,再把回答变成语音,通过已经打通的播放链路送回设备。
到了那一步,它才不只是“听见了”,而是能够真正和我对话。