PROJECT 001
AI 硬件ESP32-S3 AI 语音对话原型
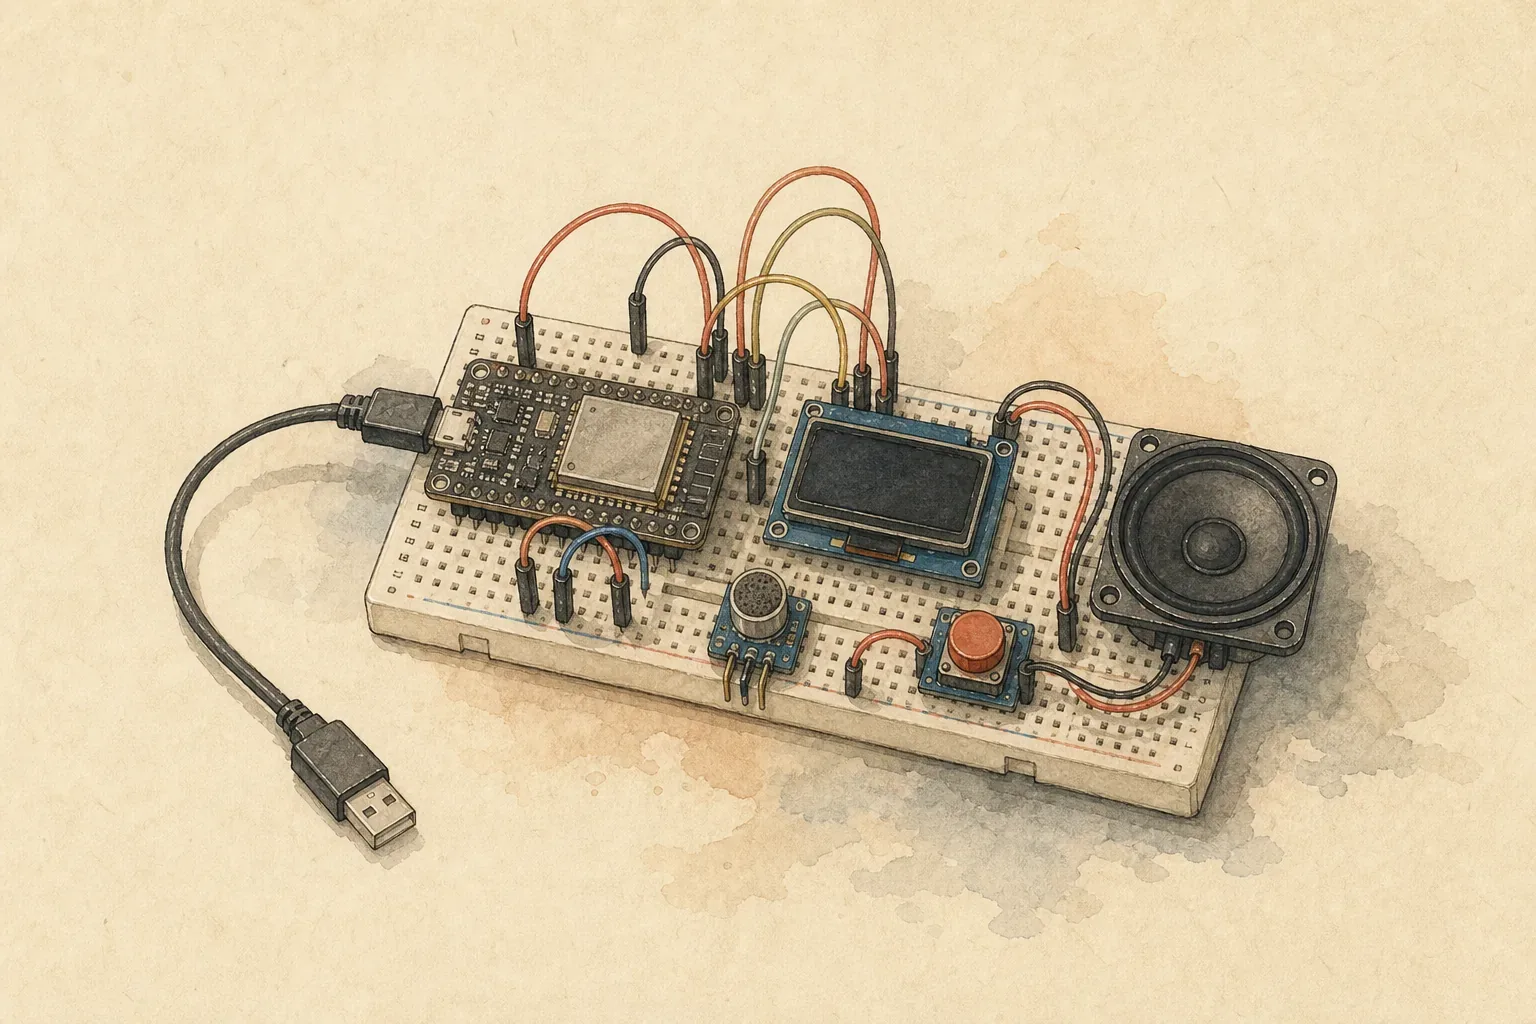
完成一套由按钮触发的 AI 语音对话原型:ESP32-S3 持续发送麦克风音频,在同一个实时会话中接收 AI 回复,并通过屏幕和扬声器完成反馈。
由 七号 制作
PROJECT OVERVIEW
作品概览
我想把 AI 语音对话从屏幕里的软件变成一套可以实际操作的硬件原型。当前已经完成一条最小但完整的按键式半双工交互链路:人按住按钮说话,ESP32-S3 持续把声音发送到云端实时语音会话,再通过屏幕和喇叭给出回答。
最终交互流程
- 按下按钮。
- 设备开始录音。
- 设备持续发送麦克风音频。
- 同一个实时语音会话完成识别与回答。
- 设备持续接收回复音频并写入播放缓冲区。
- 屏幕显示交互状态,喇叭播放回答。
当前进度
截至 2026-09-22,本期设定的语音对话目标已经 100% 完成。当前参考设备已经完成按键录音、实时音频上行、云端识别与回答、回复音频缓冲播放和屏幕状态反馈。分段入队与背压版本在一次真实回合中完整处理 325,552 bytes 回复音频,队列峰值达到 196,607 bytes,欠载次数为 0;实测确认回答完整出声、屏幕无错误且杂音明显消失。
这仍是固定参考设备上的单次 Candidate 验收,不等于稳定 Release、跨设备复测或所有用户都能直接复刻。作品完成指本期设定的最小完整语音对话目标已经实现;安装工具和正式发布门禁继续作为独立的开源交付工作推进。
从分阶段语音处理切换到实时会话,以及 ESP32 上音频、网络、内存、显示和播放调度的完整过程,记录在《ESP32-S3 语音对话终于跑通:从分阶段处理到实时会话》中。
我把 4Ω/3W 腔体喇叭接到 MAX98357A,再用 VIN → 3V3、GND → GND、BCLK → GPIO16、LRC → GPIO17、DIN → GPIO18 五根线连接 ESP32-S3。短时供电没有观察到明显异常,低音量测试程序按预期发出三声;之后,设备又通过 Wi-Fi 连续播放了五条网页生成语音。这些结果证明当前输出链路能够工作,但仍属于已记录环境中的单次播放验证。
网页动态播放的完整链路、5 个任务的闭环证据和当前边界,记录在《网页输入文字,ESP32 就能从喇叭说出来:本地语音平台播放链路实测》中。
平台侧已经把可重复使用的 MP3 与每次设备播放拆成两个对象:相同文字和相同生成配置可以复用已有语音资产,但每次发送仍建立独立播放任务和事件记录。这样既减少重复 TTS 的费用和等待时间,也保留了每次设备行为。数据模型、缓存键和旧数据迁移记录在《同一句话为什么不该重复生成 MP3:拆分语音资产与播放任务》中。
新的预焊 INMP441 已按 SCK → GPIO4、WS → GPIO5、SD → GPIO6、L/R → GND 接入。早期把 I²S 读取和屏幕刷新放在同一主循环时,3.304 秒操作只采到 5120 个样本,暴露出屏幕传输阻塞采集的问题。把 I²S 连续读取移到独立 FreeRTOS 任务后,最终联合验证记录为 3827 ms、61,184 个采样点;按 16 kHz 计算,理论值约为 61,232,差异约 0.08%。屏幕波形按约 25 FPS 局部刷新,实际观察也确认已经明显更流畅。
从 Base64 缓冲区错误到定位屏幕重绘阻塞采样的完整排查过程,记录在《ESP32 录音严重欠采样:ST7789 屏幕刷新为什么会拖垮 I²S 采集》中。
录音上传与转写链路的接线、采样调度、WAV 处理、鉴权校验和网页结果,完整记录在《ESP32-S3 + INMP441 语音输入实测:从按住录音到网页转文字》中。
旧的录音上传、网页转写和独立播放链路仍然保留为已验证的学习阶段,但最终运行时不再把它们机械串成多次请求。当前方案由 ESP32-S3 直接连接实时语音 Provider,在一个持续会话中完成音频上行、识别、回答和回复音频下行;本期原型由此完成最初设定的语音对话目标。
已经遇到的问题
第一次准备接入麦克风和音响时,我才发现模块是否焊好排针、不同端子能否直接连接,都会让纸面上的硬件清单在实物面前失效。这个过程记录在《AI 给我列了购物清单,但我花了一天时间购买配件》中。
喇叭自带的白色双针插头不能直接接入 MAX98357A 的绿色螺丝端子。我曾买过配套端子座,但当前装配没有位置使用,最后改为把金属端子从白色外壳中退出,再锁入功放端子。完整接线、三声测试和五条网页语音验证记录在《ESP32-S3 接 MAX98357A:5 根线让 4Ω/3W 喇叭播放语音》中。
接入 ST7735 屏幕后,画面右侧和底部曾出现固定彩线。通过保持接线和绘图代码不变,只切换面板初始化参数,最终确认当前屏幕需要使用 INITR_GREENTAB。完整排查过程见《ST7735 屏幕边缘出现彩色花线》。
更早接入的 GMT130-V1.0 ST7789 曾经只有背光、没有像素画面,我一度把它判断为损坏。后来保持原引脚、ST7789 驱动和 240×240 分辨率不变,改用真正应用 SPI_MODE3 的 ESP32 硬件 SPI 路径并把频率设为 1 MHz,屏幕完成了五色循环和断电重启复测。完整排查过程见《ST7789 有背光却无画面:GMT130-V1.0 从 SPI_MODE0 改成 MODE3 后点亮》。
为了把这块 GMT130 的线路重新整理清楚,我继续弄懂了七根针脚的分工,并把当前接线调整为 SCK → GPIO9、SDA → GPIO10、RES → GPIO11、DC → GPIO12,VCC 和 BLK 接 3V3,GND 接 GND。理解这些基础知识大约用了两天,实际重新走线只用了五分钟;重新上电后,屏幕仍然能够正常循环变换颜色。七根线怎样共同完成显示,整理在《ESP32 接 ST7789 屏幕:7 根线分别是做什么的?》中。
准备接入 INMP441 时,我跳过练习板直接进行了人生中的第一次焊接。六个焊点最终形态不一致,模块能否可靠使用仍待检查。完整过程见《教程看懂了,第一次焊接还是焊成了一坨》。
这些问题没有让作品停下来,反而逐渐把一个模糊的“做语音机器人”目标拆成了可以逐项连接、测试和验证的具体任务。
STEP BY STEP
制作步骤
- 01
接入按钮和显示屏
按钮与 ST7789 显示屏已经接入;屏幕可以显示中文状态、录音计时和 32 根相对声量柱。
- 02
接入录音模块
INMP441 已完成左声道 I²S 采集;采集移入独立 FreeRTOS 任务后,3827 ms 实测得到 61,184 个采样点,与 16 kHz 理论值相差约 0.08%,并能导出 PCM16 WAV。
- 03
持续发送麦克风音频
按住按钮时,设备以固定节奏把 16 kHz PCM 音频持续发送到实时语音会话;松开按钮后提交本轮输入。
- 04
处理对话并生成语音
同一个实时语音会话已经完成语音识别、AI 回答和 24 kHz PCM 回复音频下行;当前参考设备完成过真实语音回合。
- 05
接入功放和喇叭
MAX98357A 驱动 4Ω/3W 腔体喇叭播放实时回复;分段入队与背压版本完整处理 325,552 bytes,队列峰值 196,607 bytes,欠载次数为 0。
BILL OF MATERIALS
材料与工具
| 材料 | 型号 | 数量 | 用途 |
|---|---|---|---|
| 开发板 | ESP32-S3 | 1 | 控制按钮、屏幕、录音和语音播放流程 |
| TFT 显示屏 | GMT130-V1.0,1.3 英寸 240×240 ST7789 | 1 | 显示中文设备状态、录音计时和相对声量波形 |
| 按钮 | — | 1 | 触发录音 |
| 数字麦克风 | INMP441 | 1 | 采集录音 |
| I2S 数字功放 | MAX98357A | 1 | 驱动扬声器播放语音 |
| 腔体喇叭 | 3525,4Ω/3W | 1 | 播放服务器返回的语音内容 |
需要的工具
- 面包板
- 杜邦线
- 电烙铁与焊锡丝
- 尖头退针工具
- 小号螺丝刀
MAKING OF
制作日志
按发生时间回看这个作品从想法、试错到当前状态的完整过程。
教程看懂了,第一次焊接还是焊成了一坨
第一次给 INMP441 焊排针,我跳过练习板直接上手,20 分钟后留下了六个形状各异的焊点。这次翻车让我明白:教程和 AI 能教知识,但动手能力只能从实践中长出来。
ST7789 有背光却无画面:GMT130-V1.0 从 SPI_MODE0 改成 MODE3 后点亮
一块有背光却始终没有像素画面的 GMT130-V1.0,驱动芯片和分辨率其实都选对了。本文复盘我如何从软件 SPI Mode 0 黑屏,转向真正应用 SPI_MODE3 的硬件 SPI,并通过五色循环和断电重启完成复测。
ESP32-S3 接 MAX98357A:5 根线让 4Ω/3W 喇叭播放语音
记录一次已经完成的 ESP32-S3 语音播放实践:先解决喇叭插头无法接入 MAX98357A 的问题,再按 5 根线完成 I²S 接线,经过短时供电检查、三声测试音和五条网页语音验证,确认声音输出链路可用。
网页输入文字,ESP32 就能从喇叭说出来:本地语音平台播放链路实测
我把 ESP32-S3 的语音播放从“把固定音频烧进代码”改成了“在网页输入文字后动态播放”。本文记录网页、本地 TTS、任务队列、ESP32、MAX98357A 和喇叭之间怎样连成一条实际可听的链路,以及当前还没有完成的语音输入边界。
ESP32-S3 + INMP441 语音输入实测:从按住录音到网页转文字
记录 ESP32-S3 与 INMP441 从按住录音、屏幕声量反馈、WAV 上传,到服务端音频处理、whisper.cpp 转写和网页显示的完整实测链路。
ESP32 录音严重欠采样:ST7789 屏幕刷新为什么会拖垮 I²S 采集
复盘一次 ESP32-S3 录音严重欠采样故障:从 Base64 缓冲区错误,到定位低速 ST7789 重绘阻塞 I²S,再用独立 FreeRTOS 采集任务和分频局部刷新完成验证。
ESP32-S3 语音对话终于跑通:从分阶段处理到实时会话
记录一台 ESP32-S3 参考设备从完整但迟缓的录音、转写、AI 回复和语音合成链路,转向单个实时语音会话的过程;解释为什么实时交互到了资源有限的硬件上,不再只是接入一个 API,而是要重新调度音频、网络、显示与播放。