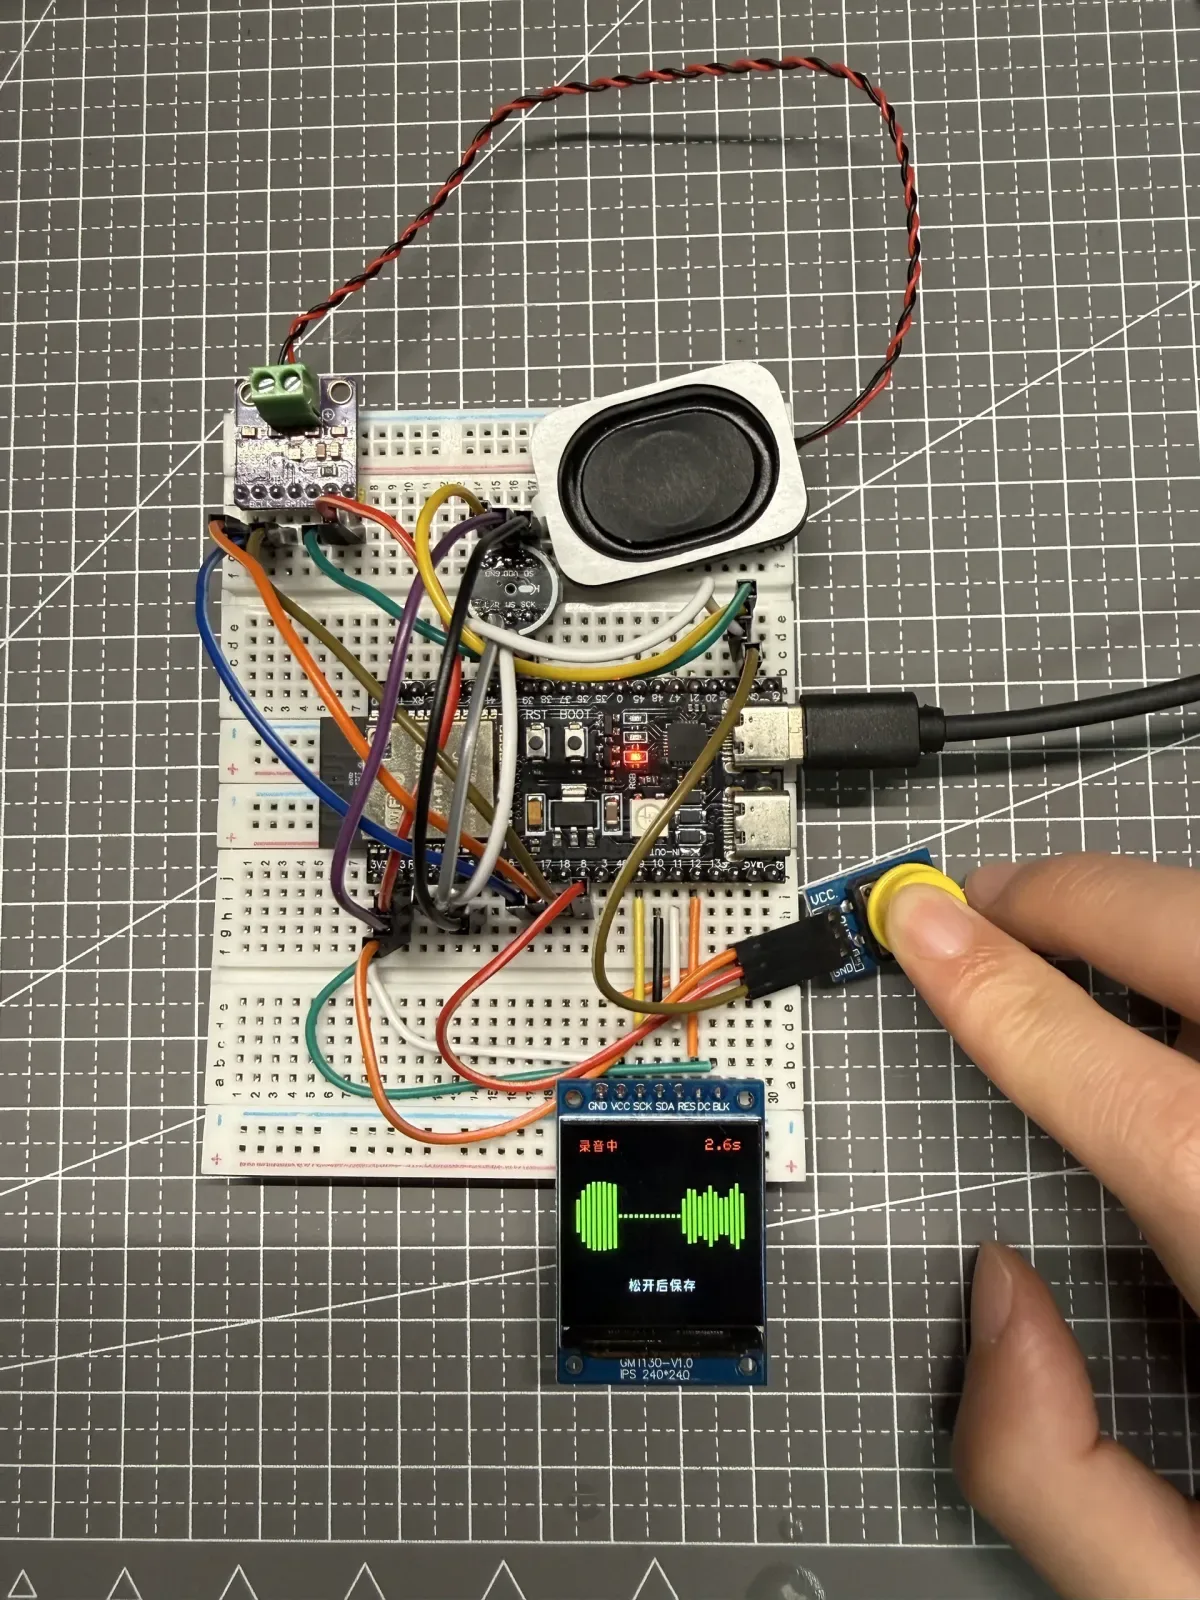
第一次听到这台 ESP32-S3 回答我时,声音其实还是一卡一卡的。
它远远谈不上顺滑,但那一刻我知道:按钮、麦克风、网络、云端 AI、屏幕和喇叭组成的完整链路,终于跑通了。对我来说,这不只是多完成了一个功能,也意味着我已经真正入门硬件开发,接下来可以开始尝试打造更多硬件产品。
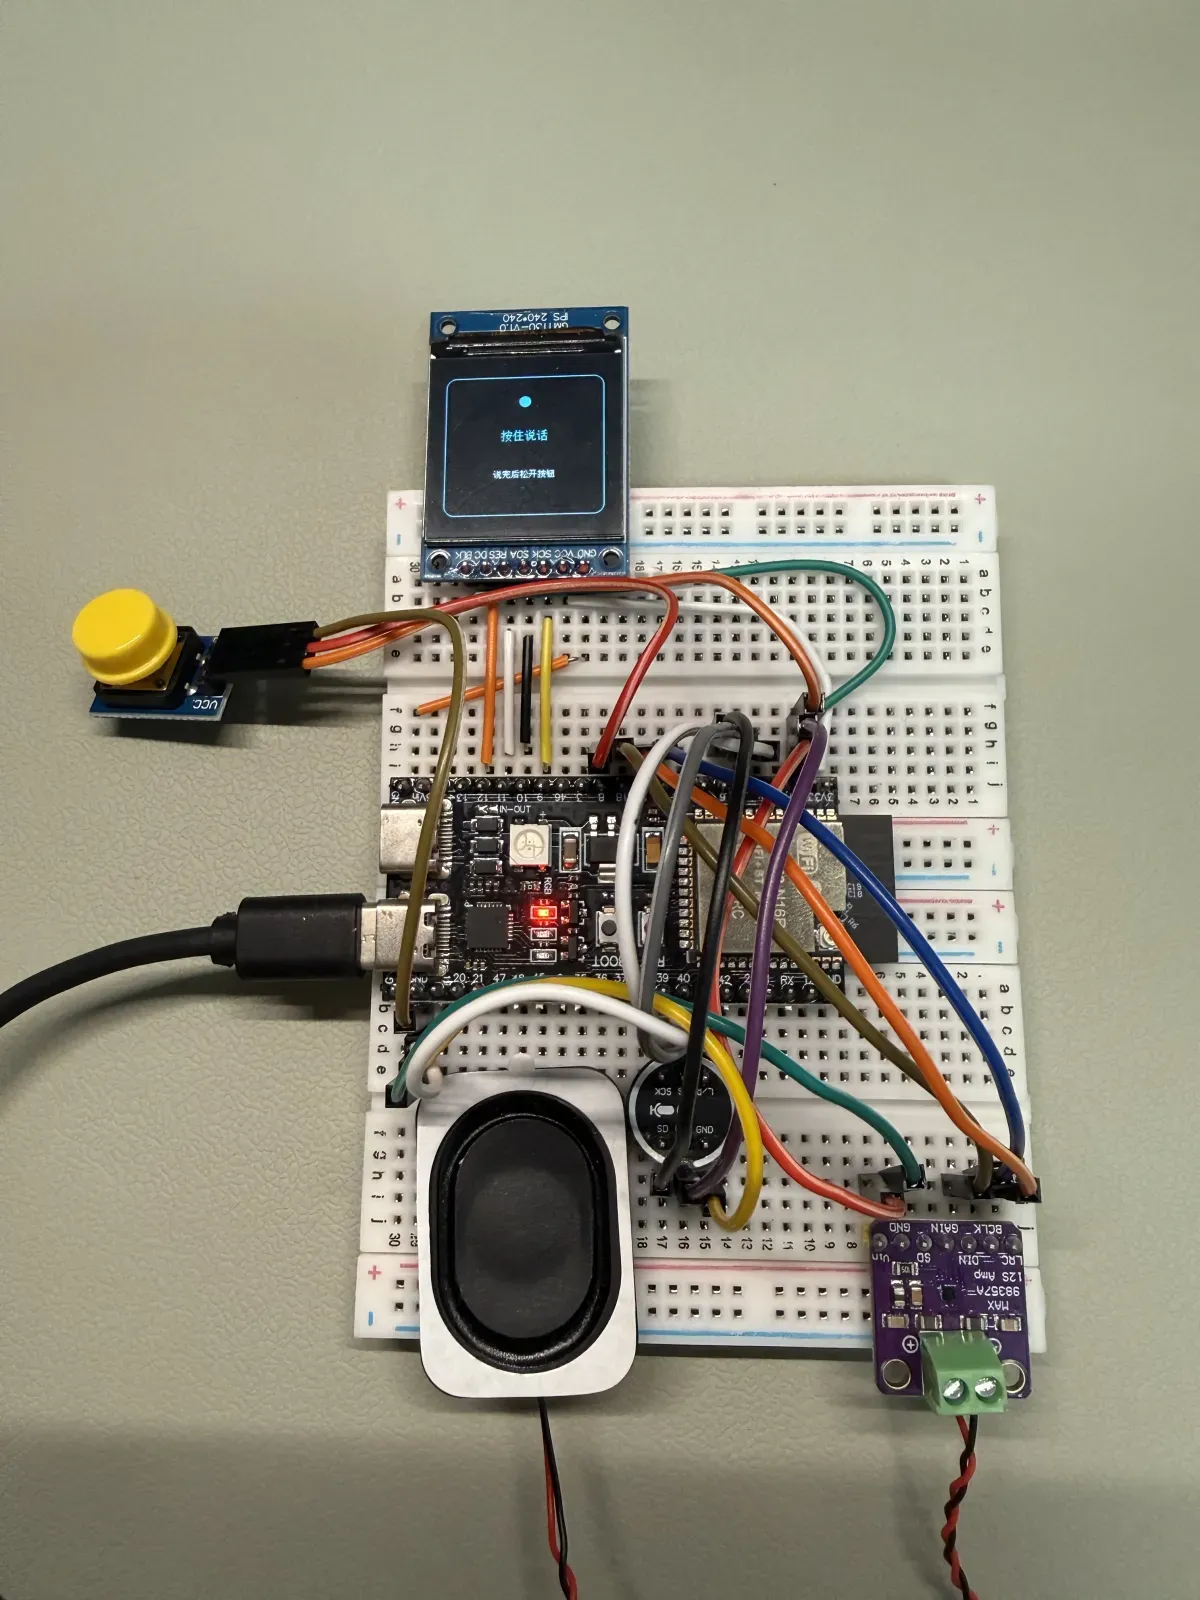
当前 ESP32-S3 语音对话原型。屏幕显示“按住说话”,同一面包板连接按钮、麦克风、功放与喇叭。
旧方案完整跑通了,但不像自然对话
我最初设计的是一条很容易理解的分阶段链路:
录音并保存
→ 把录音转成文字
→ 把文字交给 AI
→ 把回复文字合成语音
→ 从喇叭播放回复
这条流程并不是停留在设计图上。我已经把它端到端跑通了,设备确实能够在我说完话后给出语音回答。
问题出在等待体验上。录音结束以后,音频要依次经过转写、AI 回复和语音合成,每一段都有自己的请求和等待。在我的实际使用中,有时发送以后迟迟听不到声音,我会以为设备没有反应;等我已经不再注意它时,它却突然在旁边开口,甚至会把我吓一跳。
分阶段方案本身并没有错。它很适合分别调试录音、转写、回复和播放,也帮助我逐步验证了各个模块。但当目标从“每个功能都能工作”变成“设备像一次对话那样回应”,原来的组合方式就不够了。
改成实时语音,不只是换一个 API
后来,我把运行时改成了一个持续存在的实时语音会话。按住按钮说话时,设备不再等整段录音完成后才开始处理,而是持续按节奏发送音频;同一会话再返回转写、AI 回复和回复音频。
按住说话
→ 持续发送音频
→ 同一实时会话完成识别与回答
→ 持续接收回复音频
→ 缓冲并通过喇叭播放
从 Web 开发的经验看,这件事很容易被理解成“接入一个实时 API”。但到了 ESP32 上,真正复杂的是每个模块的能力都有限,而且它们必须在正确的时间配合起来。
麦克风要持续采集音频,网络连接要及时收发 WebSocket 事件,屏幕要更新状态,扬声器还要不断取得新的 PCM 数据。任何一步占用执行时间过长,都可能让另一条链路来不及工作。
真正磨人的,是有限资源之间的调度
第一版实时播放逻辑里,每收到一个音频分片,主循环就立刻完成 Base64 解码、音量处理、屏幕刷新和 I²S 写入。这个实现很直接,却把网络收包和音频播放绑在了同一条执行路径上。
Espressif 的 ESP-IDF I²S 文档明确说明,i2s_channel_write() 是阻塞式调用:在整块数据写完或超时之前,调用任务会继续等待。放在我的场景里,这意味着主循环忙着向 I²S 写一段音频时,不能同时顺畅地处理后续网络分片。
我随后把接收和播放拆开:网络侧先把 PCM 放入 PSRAM 缓冲区,独立播放任务再按固定节奏向 I²S 提供数据。这个方向并不是项目里的临时技巧;Espressif 官方的 ESP-ADF 音频框架 v2.8同样使用音频流水线和 Ring Buffer 连接不同处理环节。
但加上缓冲区以后,问题仍没有立刻结束。一次真实回答中,192 KiB 队列达到 196,607 bytes 的可用上限,旧实现只要没有一次写完整个音频分片,就会直接报告播放失败。后来改成分段入队和背压:缓冲区满时先等待播放任务释放空间,再继续写入剩余数据,而不是把一次部分写入当成整轮失败。ESP-IDF 提供的 FreeRTOS Ring Buffer 扩展也支持按内存能力创建缓冲区,为这类资源调度提供了底层工具。
最终实测中,设备完整处理了 325,552 bytes 回复音频,队列峰值再次达到 196,607 bytes,欠载次数为 0。屏幕没有报错,回答完整播放出来,我听到的杂音也明显减少。
有 AI 以后,我并不害怕重新对接
切换方案意味着以前围绕“录完再处理”和“拿到完整语音再播放”编写的代码不能直接复用,需要重新对接实时接口。硬件接线、麦克风、功放和喇叭这些基础仍然有价值,但数据流和控制逻辑需要重新设计。
这件事本身没有让我特别担心。有了 AI 协助以后,返工和重新理解代码不再像以前那么难开始。真正磨人的是实现过程里的细节:一个 Header 末尾多出的换行、一个超过库默认上限的 WebSocket 帧、一次缓冲区的部分写入,都可能让整轮对话停在不同阶段。
这些问题没有想象中顺利,却让我第一次具体理解了硬件开发和普通 Web 功能接入的区别:实时交互不是把 API 接上就结束,而是要让采集、网络、内存、显示和播放在有限资源里持续协作。
这次“跑通”的感受
目前,这台设备已经完成过按键录音、实时语音处理、屏幕状态反馈和扬声器完整回答。源码已经公开,稳定安装与配置流程仍在继续整理和验收。
第一次听到一卡一卡的回答时,我想到的不是“产品已经完成了”,而是“这条路真的能走通”。从第一次接线、第一次让屏幕显示内容,到现在让设备听见并回答,我终于不再只是照着步骤组装模块,而是开始理解怎样让多个有限的硬件能力共同完成一个产品目标。
这就是这次语音对话跑通对我的意义:我已经跨过了入门阶段,接下来可以继续去做更多真正能与人交互的硬件产品。